Featured work
Ziyang Ma, Zhikang Niu, Wenming Tu, Tianrui Wang, Ruiqi Yan, Junxi Liu, Yanru Huo, Nickk Huang, Yang Liu, Qicong Xie, Zeyu Xie, Hui Wang, Haitao Li, Zixuan Jiang, Yalin Li, Jie Fang, Yifan Duan, Zeyue Tian, Guangzheng Li, Haina Zhu, Shuyi Wang, Jinwen Wang, Mingyu Cui, Tian Tan, Auden, Sen Liang, Steve Yves, Shan Yang, Liefeng Bo, Zilong Zheng, Kai Yu, Eng-Siong Chng, Xie Chen
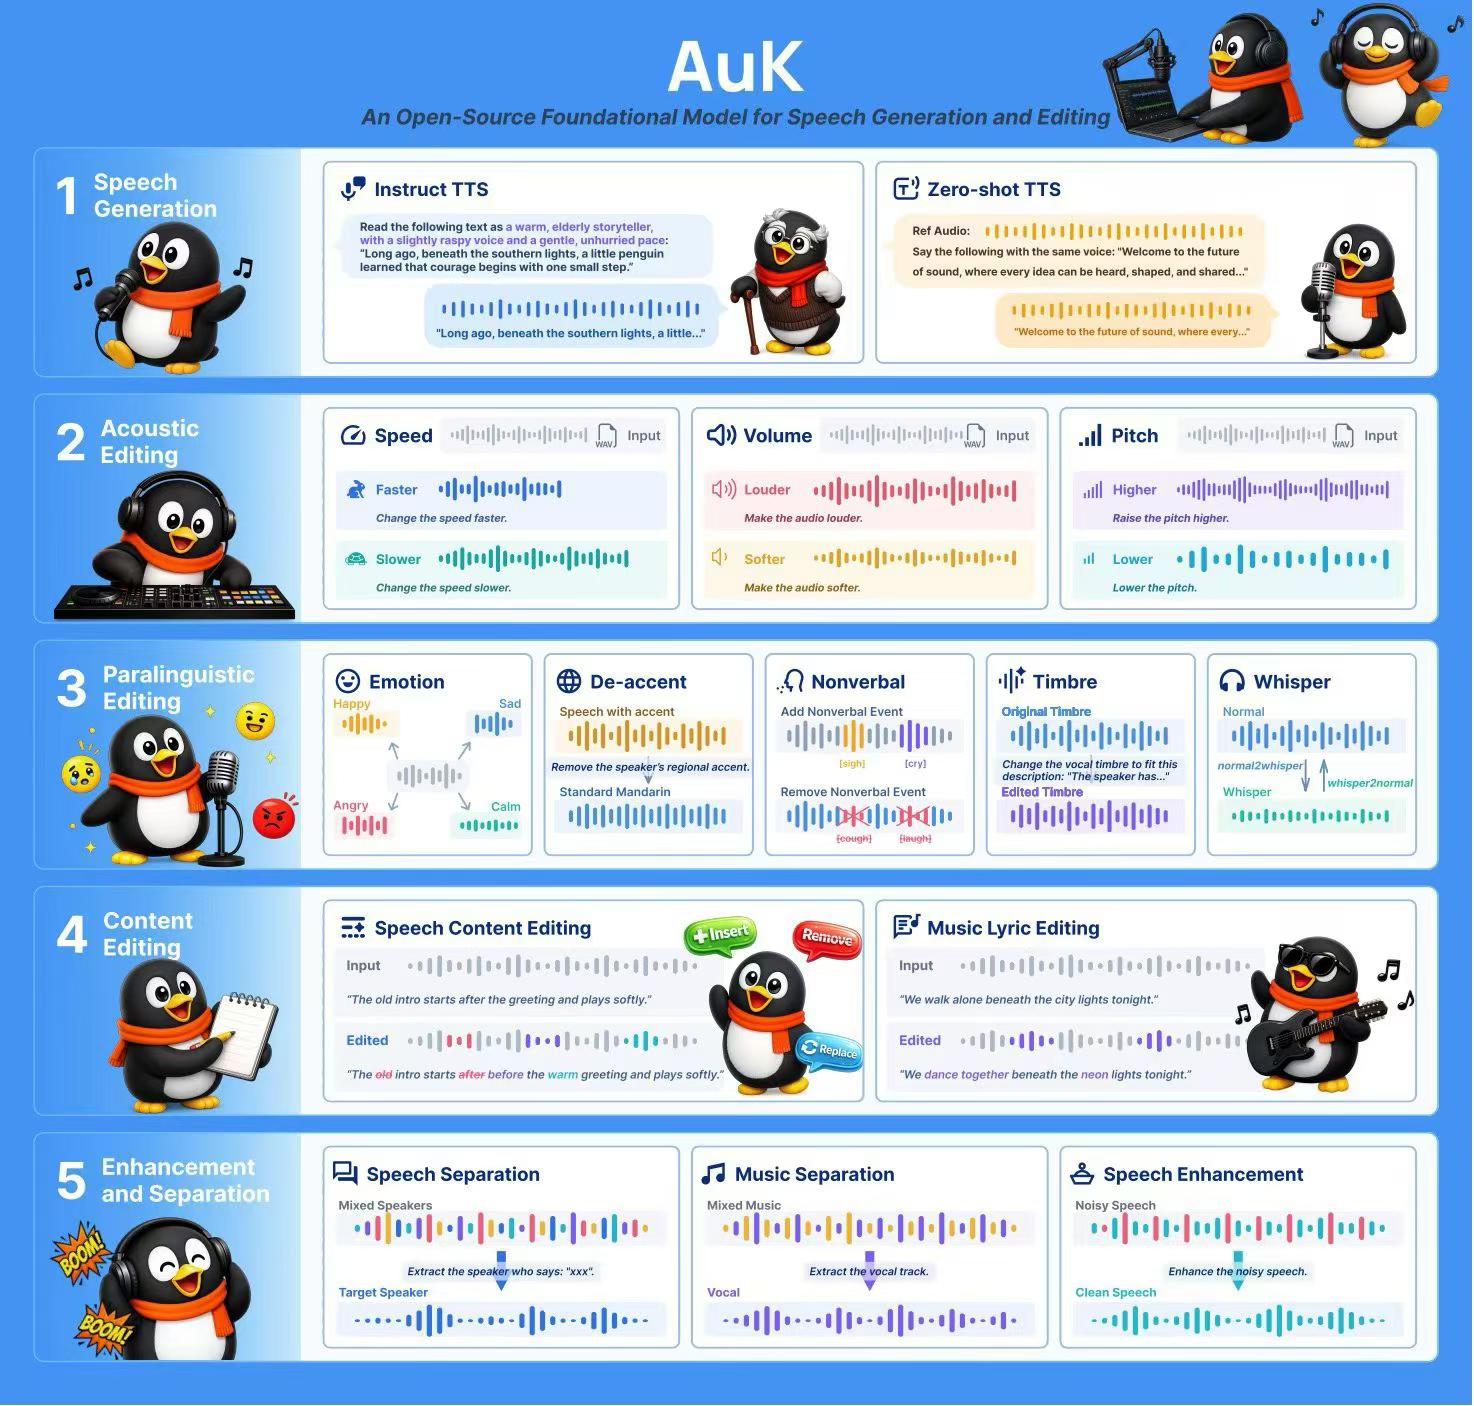
- Unifies speech generation and editing with natural-language instructions and reference audio.
- AuK-Flash: 4-step inference, approximately 4.5× faster under matched conditions.
- AuK-VAE: jointly trained on speech, music, and sound.